

Huawei prezentuje nową architekturę obliczeniową UnifiedBus dla systemów SuperPoD i klastrów
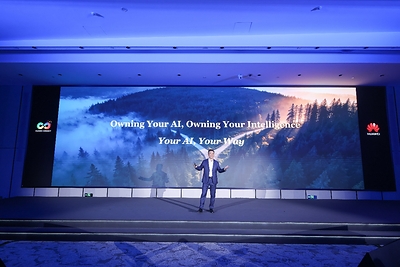
SZANGHAJ, 21 września 2026 r. /PRNewswire/ -- Podczas wystąpienia poświęconego innowacjom w architekturze obliczeniowej na HUAWEI CONNECT 2026 Yang Chaobin, członek zarządu Huawei i dyrektor generalny ICT Business Group, przedstawił nowe informacje dotyczące architektury połączeń UnifiedBus, zapowiedział serię produktów obliczeniowych opartych na tej architekturze i wyjaśnił, jak współpraca Huawei ze społecznościami open source umożliwia klientom, partnerom i programistom tworzenie nowych zastosowań.
W tradycyjnych architekturach obliczeniowych wraz ze wzrostem klastra maleje stopień wykorzystania zasobów. W klastrze obejmującym 100 000 jednostek NPU modele mogą wykorzystywać zaledwie 20% dostępnej mocy obliczeniowej, ponieważ znaczna część zasobów pozostaje bezczynna podczas przesyłania danych. Model o 10 bilionów parametrów wymaga podczas uczenia ogromnych ilości danych pośrednich, znacznie przekraczających pojemność pamięci pojedynczego akceleratora w tradycyjnej architekturze. Połączenia i komunikacja między elementami klastra stały się jednym z głównych wąskich gardeł ograniczających wydajność systemów obliczeniowych.
Według Yanga odpowiedzią Huawei na to ograniczenie jest nowa architektura obliczeniowa wykorzystująca technologię połączeń UnifiedBus, która usprawnia współpracę między klastrami i systemami SuperPoD. Architektura powstała z myślą o gwałtownie rosnącym zapotrzebowaniu na moc obliczeniową, napędzanym przez pojawiające się na rynku aplikacje wykorzystujące agenty AI. Systemy obliczeniowe oparte na UnifiedBus mają cztery najważniejsze cechy:
- Ujednolicony protokół i semantyka pamięci: ponad dziesięć protokołów połączeniowych scalono w protokole UnifiedBus, co zwiększa przepustowość połączeń z poziomu 100 GB/s do wartości rzędu TB/s i skraca czas opóźnienia transmisji w obie strony (RTT) z 7 do 2 mikrosekund. Protokół umożliwia również jednolite adresowanie całej pamięci w obrębie systemów SuperPoD.
- Współpraca heterogenicznych zasobów obliczeniowych: UnifiedBus bezpośrednio łączy procesory CPU, jednostki NPU, pamięć i dyski półprzewodnikowe (SSD), umożliwiając zdecentralizowany dostęp typu peer-to-peer oraz elastyczne łączenie zasobów CPU i NPU. Ponadto wielopoziomowa akceleracja sprzętowa dla modeli Transformer umożliwia rozdzielenie obliczeń Attention i FFN (AFD).
- Warstwowa pamięć masowa ze wspólną pulą zasobów: UnifiedBus wykorzystuje wspólną pulę zasobów opartą na różnych typach nośników, co pozwala buforować aktywacje. Pamięć Double Data Rate (DDR) może pełnić funkcję dodatkowej pamięci dla jednostek NPU, ograniczając opóźnienia w usługach wyszukiwania, rekomendacji i reklam oraz dwukrotnie zwiększając wydajność wyszukiwania wektorowego w zbiorach liczących setki miliardów elementów o tysiącach wymiarów. Rozwiązanie zmniejsza także wymagania dotyczące pojemności pamięci HBM przypadającej na jedną jednostkę NPU podczas uczenia modeli o 10 bln parametrów i poprawia wykorzystanie mocy obliczeniowej klastra mierzone wskaźnikiem MFU (Model FLOPs Utilization).
- Połączenia optoelektroniczne i elastyczna topologia sieci: UnifiedBus pełni funkcję globalnej „autostrady danych" o bardzo dużej przepustowości i bardzo małych opóźnieniach, pozwalając elastycznie zwiększać skalę zasobów obliczeniowych.
Następnie Yang przedstawił najnowsze produkty Huawei wykorzystujące UnifiedBus, które zapewniają połączenia w obrębie szaf, między szafami oraz między klastrami. Dzięki temu zasoby można elastycznie skalować od pojedynczej szafy do klastra obejmującego milion jednostek NPU.
- W obrębie szaf UnifiedBus LinkBlade dzięki konstrukcji bez okablowania eliminuje straty związane z połączeniami kablowymi, a w systemie SuperPoD obejmującym 4096 jednostek NPU pozwala ograniczyć długość przewodów miedzianych o około 196 km.
- Między szafami UnifiedBus LinkDevice obsługuje 176 portów, z których każdy zapewnia przepustowość 1,6 Tbit/s, co daje łącznie 280 Tbit/s w połączeniu całkowicie optycznym. Jest to urządzenie do szybkich połączeń opartych na protokole magistrali o największej w branży przepustowości i liczbie portów, przy opóźnieniu RTT wynoszącym zaledwie 2 mikrosekundy.
- Między klastrami przełącznik UnifiedBus UBG zapewnia współczynnik rozgałęzienia (radix) sięgający 1024, dzięki czemu może obsługiwać SuperCluster z milionem jednostek NPU, a w przyszłości także modele liczące dziesiątki bilionów parametrów.
Yang zaprezentował również SuperCluster Huawei oparty na UnifiedBus i przeznaczony do obsługi agentów AI. Tworzą go systemy TaiShan 950 i Atlas 960 SuperPoD, pamięć masowa OceanStor M900 oraz przełącznik Xinghe UBG. Klaster umożliwia współpracę różnego rodzaju zasobów obliczeniowych i warstwowe łączenie ich we wspólne pule.
Huawei zastosował technologię UnifiedBus także poza systemami SuperPoD, w swoich urządzeniach obliczeniowych. Firma opracowała nową serię urządzeń opartych na UnifiedBus, obsługujących od jednej do ośmiu jednostek NPU, a także moduły Kunpeng i Ascend. Dzięki nim małe i średnie przedsiębiorstwa mogą lokalnie uruchamiać modele liczące biliony parametrów.
W obszarze ekosystemu Yang poinformował, że Ascend współpracuje z platformami open source, takimi jak DeepSeek Harness, OpenCode i openJiuwen, nad w pełni otwartymi wtyczkami dla agentów AI obejmującymi inteligentne zarządzanie, przyspieszanie wnioskowania i bezpieczeństwo.
„Huawei stawia na innowacje na poziomie całych systemów, rozbudowę oferty produktów stanowiących podstawę infrastruktury obliczeniowej oraz otwarte oprogramowanie i otwarte systemy. Zamierzamy dalej współpracować z klientami, partnerami i programistami nad rozwojem tego ekosystemu, aby zapewnić rynkowi nową alternatywę w dziedzinie rozwiązań obliczeniowych" – podkreślił Yang.

Share this article