

Clockwork.io sammelt 31 Millionen US-Dollar ein - LinkedIn, Together AI und WhiteFiber setzen die Resilienz-Software des Unternehmens ein, um die Verschwendung von GPU-Stunden zu verhindern
LinkedIn verhindert monatlich Zehntausende von GPU-Stunden an Ausfallzeiten; neue TorchPass-Innovationen sichern den Fortschritt bei KI-Workloads ohne Codeänderungen und beschleunigen das verstärkende Lernen.
PALO ALTO, Kalifornien, 5. Oktober 2026 /PRNewswire/ -- Clockwork.io, dessen fehlertolerante Software dafür sorgt, dass KI-Trainings, verstärktes Lernen und Inferenz-Workloads auch bei Infrastrukturausfällen weiterlaufen, gab heute eine neue Finanzierung in Höhe von 31 Millionen US-Dollar, den produktiven Einsatz bei LinkedIn und Together AI sowie die erweiterte Nutzung durch WhiteFiber bekannt.
Das Unternehmen stellte außerdem zwei neue Funktionen für seine TorchPass-Lösung vor, die jeweils den Status eines laufenden verteilten KI-Jobs erfassen. Multi-Node-Plattform-Snapshots – eine Branchenneuheit für das Training – speichern einen gesamten laufenden Job über alle Knoten hinweg ohne Änderungen am Trainingscode und bewahren ihn für die Wiederherstellung auf. Schnelle, asynchrone Anwendungs-Checkpoints, die im Hintergrund während der Ausführung des Jobs erstellt werden, beschleunigen das verstärkende Lernen. Sie liefern aktualisierte Modellgewichte an die Inferenz-Replikate, die „Rollouts" generieren – also die Beispiele, aus denen das Modell lernt –, sodass diese Replikate weniger Zeit damit verbringen, zu warten oder mit einem veralteten Modell zu arbeiten.
Fehlertoleranz ist zu einer Voraussetzung für KI in großem Maßstab geworden
Große verteilte KI-Workloads können sich über Tausende von GPUs erstrecken, die synchron bleiben müssen: Eine ausgefallene GPU, eine unterbrochene Verbindung oder ein eingefrorener Server kann den gesamten Job zum Stillstand bringen. Meta berichtete von unerwarteten Unterbrechungen im Durchschnitt von etwa einer alle drei Stunden während eines 54-tägigen Zeitraums des Llama-3-Trainings auf 16.384 GPUs.
Die übliche Reaktion besteht darin, einen Checkpoint – eine gespeicherte Kopie des Fortschritts des Jobs – neu zu laden. Die Wiederherstellung kann bis zu 90 Minuten dauern, lässt funktionsfähige GPUs im Leerlauf warten und erfordert, dass der Job die seit diesem Checkpoint abgeschlossenen Arbeitsschritte wiederholt. Kunden zahlen für im Leerlauf befindliche GPUs und wiederholte Berechnungen, und die Fertigstellung der Modelle dauert länger. Mit zunehmender Größe der Jobs gefährdet jeder Neustart mehr GPU-Zeit.
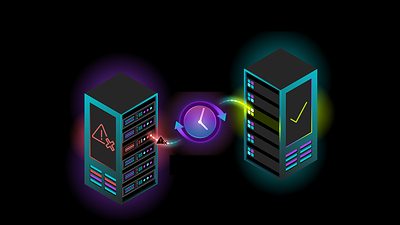
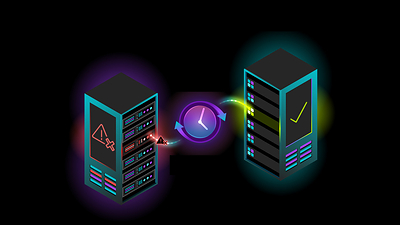
In dieser Größenordnung ist es eine Anforderung an die Infrastruktur, dass nützliche Arbeit trotz Ausfällen weiterläuft. Clockwork.io erfüllt diese Anforderung mit einer Suite zur Fehlertoleranz, die Plattformteams als Schicht zwischen der Hardware und der Arbeitslast bereitstellen. LinkPass leitet den Datenverkehr um eine ausgefallene Verbindung herum um, sodass der Job den Fehler gar nicht bemerkt. TorchPass verlagert die Arbeit von einer ausfallenden GPU auf eine funktionsfähige, sodass das Training fortgesetzt wird, anstatt zurückgesetzt zu werden. Beide Lösungen sind bereits im Einsatz. Die heute angekündigten neuen Plattform-Snapshots von TorchPass erfassen den Zustand eines laufenden verteilten Jobs, sodass der gesamte Job wiederhergestellt werden kann, wenn ein Ausfall zu groß ist, um ihn zu umgehen.
„Ausfälle sind im KI-Maßstab unvermeidlich. Der Verlust von Stunden nützlicher Arbeit durch diese Ausfälle sollte es jedoch nicht sein", sagte Suresh Vasudevan, CEO von Clockwork.io. „Fehlertoleranz ist ein Goodput-Multiplikator: Sie sorgt dafür, dass GPUs weiterhin nützliche Arbeit verrichten, anstatt auf die Wiederherstellung zu warten oder bereits erledigte Arbeit zu wiederholen. Wir haben unsere Software gemeinsam mit Unternehmen und Cloud-Anbietern entwickelt, die einige der größten GPU-Flotten betreiben, sodass sie die Ausfälle bewältigt, mit denen diese tatsächlich konfrontiert sind. Dieser Schutz gehört in die Infrastruktur, auf die sich Unternehmen und Cloud-Anbieter täglich verlassen."
Die Nutzung breitet sich in Unternehmen, bei Hyperscalern und Neoclouds aus
Unternehmen, die ihre eigenen GPU-Flotten betreiben, Hyperscaler und Neoclouds setzen Clockwork.io aus demselben Grund ein: Ein größerer Teil ihrer GPU-Stunden fließt in nützliche Arbeit.
LinkedIn hat die LinkPass-Netzwerkfehlertoleranz in seiner gesamten KI-Infrastrukturflotte implementiert und verhindert damit jeden Monat Ausfallzeiten im Umfang von Zehntausenden von GPU-Stunden.
„Bei einer KI-Infrastruktur dieser Größenordnung sollte ein einzelnes Netzwerkproblem niemals funktionierende GPUs außer Betrieb setzen oder laufende Workloads unterbrechen. Vor der Einführung von Clockwork.io konnte ein einziger Ausfall einer InfiniBand-Netzwerkkarte einen Server mit acht GPUs außer Betrieb setzen, während ein Ausfall eines Switch-Ports einen zweiten Server lahmlegen und die Auswirkungen auf 16 GPUs verdoppeln konnte", sagte Raghu Hiremagalur, SVP und CTO Infrastructure bei LinkedIn. „Clockwork.io hat dazu beigetragen, dieses Betriebsmodell zu transformieren. Die Netzwerk-Fehlertoleranztechnologie leitet den Datenverkehr automatisch auf intakte Pfade um, sodass Jobs unterbrechungsfrei weiterlaufen können, während Fehler an Verbindungen, optischen Komponenten, Kabeln oder Netzwerkkarten behoben werden. Insgesamt verhindert Clockwork.io in unserer gesamten Flotte jeden Monat Ausfallzeiten im Umfang von Zehntausenden von GPU-Stunden. Indem Clockwork.io ehemals störende Betriebsvorfälle in beherrschbare Wartungsereignisse umwandelt, hat es dazu beigetragen, die Infrastrukturauslastung und die betriebliche Effizienz zu verbessern."
Together AI bringt TorchPass als Service auf seinen GPU-Clustern auf den Markt. Auf der PyTorch-Konferenz werden die beiden Unternehmen einen Live-Trainingsjob mit mehreren Knoten demonstrieren, der trotz simulierter Netzwerk- und GPU-Ausfälle ohne Neustart fortgesetzt wird.
„Unsere Kunden bewerten uns anhand des Goodput, also des Anteils ihrer GPU-Stunden, der das Modell tatsächlich voranbringt", sagte Pavneet Ahluwalia, Produktleiter bei Together AI. „Node Repair erkennt bereits Fehler und stellt automatisch Ersatzkapazität bereit. TorchPass und LinkPass von Clockwork.io bauen auf dieser Grundlage auf und sind darauf ausgelegt, Jobs trotz GPU-Ausfällen und Verbindungsfehlern weiterlaufen zu lassen und so den Fortschritt zu bewahren. Wir bringen sie als nächste Ebene der Ausfallsicherheit auf der Plattform auf den Markt."
WhiteFiber (NASDAQ: WYFI), ein bestehender Kunde, weitet den Einsatz der Clockwork.io-Software auf seine wachsende globale GPU-as-a-Service-Infrastruktur aus.
„Es ist entscheidend, die Zuverlässigkeit eines Clusters vor der Inbetriebnahme auf Herz und Nieren zu prüfen, denn ein Kunde, der einen versteckten Fabric-Fehler erbt, zahlt später dafür in Form von fehlgeschlagenen Jobs und verlorenen GPU-Stunden", sagte Tom Sanfilippo, Chief Technology Officer bei WhiteFiber. „Optiken mit Grenzwerten, falsch konfigurierte Netzwerkkarten und Verbindungen, die zwar einen Basistest bestehen, aber unter Last an Leistung verlieren, können durchrutschen. Die automatisierte Flottenprüfung von Clockwork.io validiert jede Verbindung und jeden Knoten auf einmal, lokalisiert Fehler innerhalb von Minuten und ermöglicht es uns, diese vor der Abnahme zu beheben. Wir nehmen Cluster schneller in Betrieb, und der erste Trainingslauf eines Kunden läuft auf einer Fabric, die durchgängig validiert wurde – und nicht nur eingeschaltet ist. Angesichts der rasant wachsenden Marktnachfrage ist es für unser Geschäft entscheidend, validierte Kapazitäten schnell an Kunden bereitzustellen, und deshalb erweitern wir den Einsatz von Clockwork.io auf alle unsere Cluster."
Neue TorchPass-Funktionen legen den Schutz von Workloads in die Hände der Plattformteams
Clockwork.io hat TorchPass über die GPU-Migration hinaus um zwei Funktionen erweitert, über die Plattformteams bisher nicht verfügten: einen Snapshot eines gesamten verteilten Jobs, den sie selbst erstellen können, und Anwendungs-Checkpoints, die schnell genug sind, um im Hintergrund ausgeführt zu werden.
Beim Training speichern Plattform-Snapshots den Ausführungsstatus eines laufenden Jobs über alle seine Knoten hinweg, sodass der Job nach einer Unterbrechung wiederhergestellt werden kann. Plattformteams und KI-Infrastrukturingenieure setzen dies für unterstützte Workloads ein, ohne darauf warten zu müssen, dass Anwendungsbesitzer ihren Code ändern oder Checkpoint-Logik hinzufügen. Unternehmensteams können Trainingsjobs in ihrer gesamten Flotte mit einem einzigen Mechanismus schützen, und Cloud-Anbieter können Kundenjobs schützen, über deren Code sie keine Kontrolle haben. Wenn Teams Checkpoints auf Anwendungsebene erstellen, können die schnellen Checkpoints von TorchPass häufiger erstellt werden, sodass nach einem Ausfall weniger Fortschritt verloren geht und weniger Rechenaufwand wiederholt werden muss.
Bei der Inferenz laufen große Modelle auf zwei oder mehr Servern, sodass eine einzige fehlerhafte Verbindung eine gesamte Replik lahmlegen und eine Benutzersitzung oder eine Agenten-Aufgabe mitten im Ablauf unterbrechen kann. LinkPass sorgt dafür, dass diese Repliken auf mehreren Servern auch bei Verbindungsausfällen weiterarbeiten.
Verstärkendes Lernen hängt sowohl vom Training als auch von der Inferenz ab. Kopien des Modells generieren Rollouts, der Trainer lernt daraus, und aktualisierte Gewichte müssen die Kopien erreichen, bevor diese mit der neuesten Version generieren können. Die Anwendungs-Checkpoints von TorchPass übertragen die aktualisierten Gewichte schneller an die Rollout-Replikate, während LinkPass dafür sorgt, dass diese Replikate auch bei Verbindungsausfällen weiterarbeiten.
„Die Fehlertoleranz von Clustern war früher ein Problem beim Training. Mittlerweile ist sie auch ein Problem bei der Inferenz", sagte Dylan Patel, Gründer, CEO und Chefanalyst bei SemiAnalysis, dessen ClusterMAX-Bewertungen GPU-Cloud-Anbieter benchmarken. „In unserem ClusterMAX reduziert TorchPass den Goodput-Verlust beim Training für eine Neocloud mit Gold-Rating von 14 % auf unter 3 %. Reinforcement Learning (RL) verbindet beide Aspekte miteinander: Inferenz-Replikate generieren Rollouts, der Trainer lernt daraus, und die aktualisierten Gewichte werden an die Replikate zurückgesendet. Clockwork.io sorgt dafür, dass die Replikate auch bei Verbindungsausfällen und Netzwerkstörungen weiterlaufen. Seine extrem schnellen Checkpoints beschleunigen die Rückübertragung der Gewichte in die Rollout-Flotte, sodass der Lauf in keiner Richtung ins Stocken gerät. Eine einzige Fehlertoleranzschicht für Training, Inferenz und RL – genau hier muss die Lösung liegen."
Teams von Unternehmensplattformen und Cloud-Anbieter können sich an Clockwork.io wenden, um die Software für ihre Workloads zu evaluieren oder Möglichkeiten für eine Partnerschaft zu erkunden.
Die Finanzierungsrunde und was damit finanziert wird
Die Runde wurde gemeinsam von Premji Invest, Wing Venture Capital und Seligman Ventures angeführt, unter Beteiligung der bestehenden Investoren NEA und e& Capital. Damit beläuft sich die Gesamtfinanzierung von Clockwork.io auf 73 Millionen US-Dollar. Das Unternehmen wird das Kapital nutzen, um die Einführung seiner Suite für Fehlertoleranz in den Bereichen Training, Inferenz und bestärkendes Lernen zu beschleunigen, die Akzeptanz in Unternehmen zu steigern und die Bereitstellung über Cloud-Partner auszuweiten.
„Das Einzige, was sich perfekt skalieren lässt, ist Unzuverlässigkeit: Steckt man genug GPUs in einen Rechner, fällt immer irgendetwas aus", sagte Greg Papadopoulos, Venture Partner bei NEA. „Das alte Vorgehen – den Job stoppen und einen Checkpoint neu laden – macht bei den heutigen Größenordnungen keinen Sinn mehr. Clockwork behandelt Ausfälle als Normalzustand: TorchPass verlagert das Training live von einer ausgefallenen GPU und erstellt nun Snapshots eines gesamten laufenden Jobs ohne Codeänderungen. Dadurch werden bereits Zehntausende von GPU-Stunden pro Monat eingespart. Wir haben Clockwork.io erstmals 2021 finanziell unterstützt und freuen uns sehr, das Unternehmen weiterhin zu fördern, während es die Leistungsschicht des KI-Clusters definiert."
Informationen zu Clockwork.io
Clockwork.io ist Vorreiter bei Software-Driven AI Fabrics™, einer programmierbaren Schicht zwischen Hardware und Workload, die GPU-Cluster beobachtbar, fehlertolerant und über jeden Beschleuniger, jedes Netzwerk und jede Cloud hinweg voll auslastet. KI-Workloads erfordern, dass der gesamte Cluster als eine einzige Maschine agiert, doch Ausfälle und Engpässe führen dazu, dass GPUs ungenutzt bleiben. Die FleetLens"-Plattform von Clockwork.io gewinnt diese verlorene Kapazität zurück: Nanosekundengenaue Telemetrie lokalisiert die GPU, den Knoten oder die Verbindung, die einen Job verlangsamt oder zum Stillstand bringt, validiert Cluster vor dem Start und sorgt mit „LinkPass" und „TorchPass" dafür, dass Workloads trotz Infrastrukturausfällen und Leistungseinbußen weiterlaufen – vom Training bis zur Inferenz. SemiAnalysis hat in unabhängigen Benchmarks festgestellt, dass TorchPass Ausfälle schneller behebt als Checkpoint-Restart und führende Open-Source-Frameworks. LinkedIn, Together AI, WhiteFiber, Wells Fargo, Nebius, NScale und DCAI vertrauen auf Clockwork.io als Grundlage für ihre KI-Infrastruktur. Weitere Informationen finden Sie unter www.clockwork.io.

Share this article