Huawei Perkenal OceanStor M900 Context Memory Storage Percepat Inferens AI di Pusat Data Hiperskala

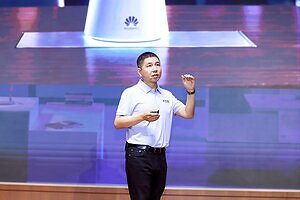
SHANGHAI, 18 September 2026 /PRNewswire/ -- Pada HUAWEI CONNECT 2026, David Wang, Timbalan Pengerusi Lembaga dan Pengerusi Bergilir Huawei, secara rasmi memperkenalkan OceanStor M900 Context Memory Storage semasa ucaptamanya. Direka untuk inferens AI di pusat data hiperskala, produk itu menyediakan SuperPoD dengan ruang memori dikongsi sepenuhnya yang menawarkan kapasiti berskala PB dan prestasi bertaraf TB/s. Ini menandakan peralihan infrastruktur AI daripada model berpusatkan pengkomputeran kepada kerjasama mendalam antara pengkomputeran, rangkaian dan storan. Ini akan membantu menyerlahkan kuasa pengkomputeran SuperPoD.
Tahun 2026 menyaksikan peralihan AI yang semakin pantas daripada kemajuan teknologi kepada pelaksanaan berskala besar. Aplikasi AI telah berkembang daripada bot sembang (chatbot) kepada ejen yang mampu menyelesaikan tugas kompleks secara autonomi. Ejen ini diterima pakai secara meluas dalam sektor kritikal yang menandakan permulaan era AI berejen.
Apabila model besar berkembang kepada parameter berskala 10 trilion, SuperPoD menjadi pilihan optimum bagi infrastruktur AI. Model besar arus perdana sudah pun menyokong tetingkap konteks melebihi satu juta token, inferens berbilang pusingan dan tugas kompleks telah menjadi kebiasaan, manakala data cache KV yang dijana semasa inferens terus berkembang. Trend ini telah mendorong memori dalam cip dan DRAM melampaui hadnya dari segi kapasiti dan keberkesanan kos. Pembinaan sistem storan berbilang peringkat yang menyelaraskan memori dalam cip, DRAM dan SSD untuk mewujudkan ruang memori dikongsi sepenuhnya dengan kapasiti yang sangat besar telah menjadi konsensus industri.
Huawei memperkenalkan OceanStor M900 Context Memory Storage untuk mengatasi kekangan kapasiti memori dalam konteks ultra-panjang dan inferens berbilang pusingan. OceanStor M900 menggunakan rangkaian UnifiedBus untuk membina cache KV berbilang peringkat global berskala PB dengan sambungan satu lompat. Ini dapat menyerlahkan sepenuhnya potensi kuasa pengkomputeran SuperPoD dan mempercepat inferens AI di pusat data hiperskala. OceanStor M900 Context Memory Storage mempunyai tiga keupayaan utama:
Menembusi Batas Kapasiti untuk Memperkasakan AI Berskala Besar dengan Memori Berkapasiti Sangat Besar
Dikuasakan oleh rangkaian saling sambung UnifiedBus berkelajuan tinggi, cache KV mencapai pengumpulan dan perkongsian global dengan storan berperingkat. Cache KV SuperPoD diperluas daripada memori dalam cip dan DRAM kepada SSD, membolehkan satu kluster menyediakan kapasiti sebanyak 64 PB. Kapasiti cache KV yang tersedia bagi setiap NPU dinaik taraf daripada gigabait kepada terabait, membolehkan lebih banyak konteks disimpan, dikongsi dan digunakan semula. Ini meningkatkan nisbah kena cache KV dengan ketara.
Meningkatkan Prestasi Inferens untuk Menyerlahkan Kuasa Pengkomputeran Sepenuhnya
OceanStor M900 merupakan seni bina pertama dalam industri yang mengintegrasikan CPU, unit pengawal rangkaian dan unit pengawal NAND. Ia menyediakan semantik KV natif bagi mengupayakan sambungan satu lompat daripada NPU SuperPoD kepada SSD. Ini dapat menghapuskan keperluan terhadap penukaran protokol dan pemajuan CPU, sekali gus mengurangkan kependaman akses secara drastik daripada milisaat kepada 60 mikrosaat, iaitu pengurangan sebanyak 90%. Satu kluster menyediakan lebar jalur akses agregat 40 TB/s, 1.5 kali lebih tinggi berbanding penyelesaian setara. Dalam senario pengaturcaraan AI biasa, seni bina ini menggandakan daya pemprosesan token kluster inferens dan mengurangkan separuh masa untuk menghasilkan token pertama, sekali gus menukarkan kuasa pengkomputeran kepada produktiviti.
Mengurangkan Kos Token untuk Membolehkan Penerimagunaan AI Berskala Besar Berkesan Kos
OceanStor M900 menggunakan teknologi storan adaptif peka-KV yang pertama dalam industri, yang meramalkan kitaran hayat cache KV berdasarkan nilai data dan mengagihkan data secara pintar dalam media storan. Teknologi ini membolehkan sehingga 24 penulisan pemacu setiap hari (DWPD), memanjangkan ketahanan SSD sebanyak 16 kali ganda dan memastikan kestabilan selama tiga tahun. Dengan mengurangkan kos penggantian media serta operasi dan penyelenggaraan (O&M), ia dapat mengurangkan kos jangka panjang infrastruktur inferens AI berskala besar dan membolehkan penerimagunaan AI yang lebih pantas.
Ketika AI berkembang ke dalam sistem pengeluaran utama dalam semua jenis industri, infrastruktur AI sedang berkembang daripada model berpusatkan pengkomputeran ke arah kerjasama pengkomputeran-rangkaian-storan yang lebih erat. Storan memori konteks akan menjadi penting untuk terus meningkatkan kapasiti dan kecekapan akses cache KV inferens hiperskala.
SOURCE Huawei

Share this article